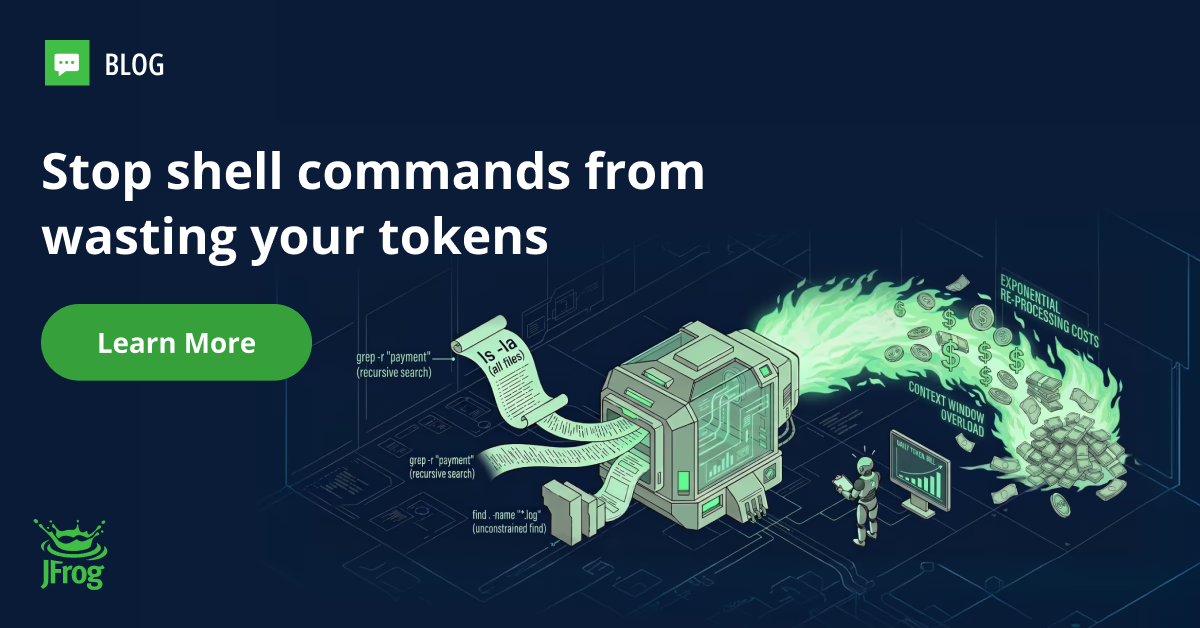
Chi phí token của các lệnh Shell
Bạn đã yêu cầu tác nhân AI lập trình của mình gỡ lỗi một lỗi kiểm thử đơn giản, và nó bằng cách nào đó lại đọc đệ quy toàn bộ lịch sử .git/objects của bạn. Nếu hóa đơn API của bạn đang tăng trong khi tác nhân dường như chỉ “duyệt” mã nguồn, bạn không phải người duy nhất.
Các nhà phát triển thường đổ lỗi cho lựa chọn mô hình LLM hoặc prompt hệ thống viết kém. Nhưng kẻ tiêu tốn ngân sách thực sự là ngữ cảnh đầu vào. Agent của bạn không tốn tiền để suy nghĩ, mà tốn tiền để đọc lại một đầu ra grep dài 4.000 dòng mà nó đã hiểu sáu lượt trước đó. Kẻ thủ chính là những lệnh shell hàng ngày mà các nhà phát triển đã dùng trong nhiều thập kỷ mà không suy nghĩ thêm.
Tại sao các lệnh shell lại làm bể ngân sách của tác nhân AI?
Các lệnh shell như ls, find và grep được xây dựng cho con người, và bộ não con người tự động lọc nhiễu terminal để tìm ra một dòng quan trọng. Các tác nhân AI không có bộ lọc đó. Chúng xử lý đầu ra terminal thô như ngữ cảnh chịu phí. Ngay cả khi tác nhân sau đó tóm tắt lịch sử, việc nhập ban đầu của những đầu ra lớn, không được lọc này gây ra những cú nhảy token nghiêm trọng.
Khi các tác nhân lập trình tự động chuyển từ autocomplete đơn giản sang lập kế hoạch và thực hiện các workflow nhiều bước trên terminal, chúng gọi các lệnh này lặp đi lặp lại. Mỗi lần gọi thêm các token bị cộng dồn nhanh chóng cho đến khi phiên kết thúc hoặc tác nhân gộp lịch sử lại. Khoảng cách giữa con người lướt qua một đầu ra và tác nhân “hấp thụ” từng ký tự là nơi ngân sách của bạn bị thiêu rụi.
Ba thủ phạm thường gặp
Bên cạnh các log kiểm thử dài dòng, ba lệnh shell thông thường sau đây thường là nguồn chi phí mất kiểm soát trong workflow agentic. Nhận diện chúng là bước đầu để kiểm soát chúng.
- ls, đổ thư mục: Một tác nhân hỏi thư mục có gì và chạy ls -la. Trong một thư mục nhỏ thì vô hại. Trong root của một monorepo, lệnh đơn đó có thể đổ ra hàng chục nghìn token gồm quyền truy cập, thời gian, kích thước file và các file ẩn mà chẳng ai quan tâm.
- find, cây vô tận: Khi được hỏi “cấu hình database ở đâu?”, tác nhân chạy find . -name “*.yaml”. Nếu không giới hạn độ sâu, find sẽ duyệt đệ quy mọi thư mục ẩn, thư mục cache và đường dẫn artifact build mà nó có thể chạm tới.
- grep, kẻ nuốt ngữ cảnh: Một tác nhân săn tìm một gọi hàm chạy grep -r “processPayment”. Nếu không bị giới hạn, nó có thể trả về JavaScript đã minify, dữ liệu nhị phân rác, và vô tận mock test. Tệ hơn, nếu nó khớp một dòng dài 10.000 ký tự trong file JSON sinh tự động, toàn bộ dòng đó sẽ lọt vào prompt.
Mỗi lệnh này ở mức độ đơn lẻ là an toàn và ở quy mô là đắt đỏ, chính vì vậy chúng thường lọt qua code review mà không ai chú ý.
Tại sao cắt ngắn mù quáng không giải quyết được vấn đề?
Cắt ngắn mù quáng đầu ra shell (ví dụ: chặn mọi lệnh ở 1.000 token) nghe giống một giải pháp nhanh, nhưng nó lặng lẽ phá hỏng khả năng suy luận của tác nhân về thứ nó đang xem.
Nếu bạn âm thầm cắt ngắn kết quả grep, tác nhân có thể không biết rằng nó chỉ nhận được kết quả một phần. Nó có thể cho rằng kết quả không tồn tại. Từ đó, nó có thể đoán bừa, ảo tưởng, hoặc rơi vào vòng xoáy. Trong thử nghiệm nội bộ của chúng tôi, các tác nhân đã chạy lại cùng một lệnh ls đến sáu lần cố gắng thiết lập lại vị trí trong filesystem.
Một optimizer mà tác nhân không phát hiện được là optimizer bạn không thể debug. Bất kỳ lớp nén nào bạn xây dựng phải báo cho tác nhân biết những gì nó không thấy, nếu không bạn đang đổi một vấn đề chi phí lấy một vấn đề tính đúng đắn. Đây chính là failure mode mà một công cụ nén token như JFrog Boost được thiết kế để tránh. Nó nén đầu ra và báo cho tác nhân khi đã làm vậy, để tác nhân có thể yêu cầu đầu ra đầy đủ nếu cần.
Hiệu ứng quả cầu tuyết: Một lệnh xấu nhân lên như thế nào
Đây là chi phí dễ bị bỏ sót nhất trong workflow agentic: một lệnh xấu không chỉ được trả tiền một lần. Vì cách các cuộc hội thoại LLM đa lượt thường hoạt động, các token của lượt trước được gửi lại cùng mỗi tin nhắn mới cho tới khi phiên kết thúc, tác nhân gộp lịch sử, hoặc tới giới hạn ngữ cảnh.
Hành vi gửi lại này biến lãng phí nhỏ thành lãng phí kép. Giá trị việc cắt ngắn đầu ra của một lệnh không chỉ là số token bạn đã cắt, mà là số token đó nhân lên theo số lượt mà chúng sẽ ngồi trong ngữ cảnh. Ví dụ, một log 3.000 token bị loại bỏ ở lượt 4 của phiên 40 lượt không phải là tiết kiệm 3.000 token. Trước khi có prompt caching hoặc gộp lịch sử, nó là hơn 100.000 token đầu vào tránh được trong suốt phiên.
Scenario
Tokens removed once
Turns remaining in session
Cumulative tokens saved
Trim at turn 4 of 40
3,000
36
~108,000
Trim at turn 20 of 40
3,000
20
~60,000
Trim at turn 38 of 40
3,000
2
~6,000
Tính toán minh họa. Giả sử không có prompt caching hoặc gộp lịch sử.
Càng sớm một đầu ra lệnh được tối ưu hóa, tối ưu đó càng có giá trị vì nó tránh được việc được xử lý lại trong mọi lượt sau đó, không chỉ lượt hiện tại. Lưu ý: prompt caching có thể giảm một số chi phí xử lý lại, nhưng thời hạn cache và mức giảm giá khác nhau theo nhà cung cấp và mô hình, và các token đã cache vẫn bị tính phí. Theo chúng tôi, caching bổ trợ cho tối ưu hóa đầu ra chứ không thay thế nó.
Tại giá niêm yết tính đến tháng 10 năm 2026, 100.000 token đầu vào có giá khoảng $0.15 đến $0.30 trên các mô hình như GPT-5 hoặc Claude Sonnet 5, trước khi áp dụng cache hoặc chiết khấu theo lô. Nghe có vẻ rẻ cho tới khi điều đó lặp lại. Nếu mỗi trong 50 phiên gỡ lỗi hàng ngày lãng phí ~100.000 token đầu vào vì nhiễu, con số này cộng lại khoảng $200–$300 một tháng theo các mức đó. Thoắt một cái, một đội ngũ đang thiêu rụi trăm đô mỗi tháng để tác nhân AI nhìn chằm chằm vào các thư mục cache ẩn.
Ý chính: Tiết kiệm 2.000 token ở một lệnh grep ban đầu có thể tiết kiệm nhiều hơn rất nhiều so với việc cắt cùng 2.000 token ở cuối phiên, vì những 2.000 token đó sẽ được xử lý lại trong mọi lượt sau đó.
Làm sao để ngăn các lệnh shell rút cạn ngân sách token?
Nếu bạn đang xây dựng workflow agentic, server MCP, hoặc công cụ developer tùy chỉnh, bạn cần một lớp tối ưu hóa tỉa nhiễu mà không làm mù LLM về những gì nó bị bỏ qua. JFrog Boost, một wrapper CLI miễn phí hiện đang public preview, được xây dựng xung quanh bốn quy tắc tối ưu hóa mà mọi đội có thể áp dụng ngay cả khi không dùng công cụ đó.
- Ép ràng buộc theo mặc định. Nơi thiết lập tác nhân cho phép, hãy điều hướng các lệnh shell qua các phiên bản bọc thay vì lệnh thô. Tiết lộ các alias hoặc phiên bản bọc mà tự động áp đặt giới hạn — một ls “an toàn” ép ls -1 (chỉ tên) thay vì ls -la, và một find “an toàn” ép giới hạn độ sâu, ví dụ find . -maxdepth 2 -name “*.ts”.
- Báo cho tác nhân biết bạn đã lọc gì. Nếu một log 10.000 dòng phải bị cắt, đừng làm im lặng. Thêm một message hệ thống vào đầu ra để tác nhân biết đó là tóm tắt, không phải toàn bộ bức tranh.
- Cung cấp “cửa thoát” khôi phục. Cho tác nhân một tool cụ thể, ví dụ cat_full_file, để nó có thể yêu cầu rõ ràng dữ liệu bị loại bỏ thay vì ảo tưởng.
- Giám sát đường hồi phục. Theo dõi tần suất tác nhân thực sự dùng “cửa thoát” đó. Theo quan điểm của chúng tôi, tỉ lệ truy xuất (retrieve rate) là thước đo khả dụng tốt hơn so với chỉ số tỷ lệ nén.
Áp dụng nhất quán những quy tắc này giúp giữ ngữ cảnh tác nhân gọn nhẹ mà không để nó đoán bừa về những gì nó không thấy.
Xây một wrapper công cụ an toàn giảm rủi ro injection
Để làm cho điều này cụ thể, hãy xem cách triển khai Quy tắc 1 (ép các ràng buộc an toàn). Thay vì để tác nhân AI thực thi grep trực tiếp trên hệ điều hành, chúng ta tạo một hàm Python đóng vai “wrapper” quanh lệnh.
Wrapper này chặn yêu cầu của tác nhân, làm cho lệnh an toàn, chạy nó, rồi lọc đầu ra trước khi gửi lại cho LLM. Đây là cách JFrog Boost và các công cụ tương tự xây dựng các mẫu cơ bản này, phân tách theo bước:
Step 1: Pass the Command Arguments as a List. First, we construct the command. Instead of passing a single string to the shell (which can expose you to command injection), we pass a list of separate arguments. We also force grep to ignore notorious token-wasting directories like .git and node_modules.
import subprocess
def safe_grep(search_term: str, directory: str = “.”):
“”””Illustrative agent tool for searching a codebase with output limits.”””
1. Passing arguments as a list (no shell) reduces command-injection risk
cmd = [
“grep”, “-r”, “-n”, “-I”,
“–exclude-dir=.git”, “–exclude-dir=node_modules”, “–exclude-dir=dist”,
“-e”, search_term, “–“, directory,
]
Step 2: Execute Safely and Capture Output. Next, we run the command. We explicitly set check=False so that if grep finds nothing (which returns a non-zero exit code), it simply returns an empty string rather than crashing our entire agent loop.
try:
2. Execute without shell=True
   result = subprocess.run(cmd, capture_output=True, text=True, check=False)
   output = result.stdout
Step 3: Enforce Limits and Add the Recovery Hatch. Finally, we check the length of the output. If it exceeds our token limit (roughly 8,000 characters), we truncate it. Crucially, we append a [System] note directly to the output. This tells the LLM exactly what happened and gives it the exact tool command (cat_file) it needs to use if it genuinely needs to read the rest of the file.
3. Token limit safeguard (~2000 tokens)
   char_limit = 8000
   if len(output) > char_limit:
       truncated_output = output[:char_limit]
       # 4. Tell the agent what happened and provide the recovery hatch
       return (
           f"{truncated_output}\n\n"
           "[System: Output truncated. Use `cat_file` for specific files.]"
       )
   return output
except Exception as e:
return f”[System Error: {str(e)}]”
Wrapper này truyền đối số như một danh sách thay vì một chuỗi shell, điều đó giảm rủi ro command-injection, và nó ghép mỗi lần cắt ngắn với một chú thích rõ ràng để tác nhân có thể hành động. Phiên bản production nên giới hạn những đường dẫn mà tác nhân có thể tìm kiếm và chạy với privilege ít nhất cần thiết. Đầu ra của tác nhân chỉ đáng tin cậy và tiết kiệm chi phí khi những gì nó được phép tiêu thụ được kiểm soát; đừng để một lệnh shell bật ra làm phá hủy niềm tin đó.
JFrog Boost giúp thế nào: Xây và scale agents với sự tự tin
Bọc thủ công mọi lệnh shell là một khởi đầu hợp lý, nhưng nó không mở rộng khi cả đội chạy hàng chục workflow agentic mỗi ngày. JFrog Boost, hiện đang public preview, được thiết kế để áp dụng các quy tắc này tự động: nó là một wrapper CLI miễn phí nén đầu ra ồn trước khi nó tới các tác nhân như Cursor, Claude Code, hoặc GitHub Copilot. JFrog Boost được thiết kế để loại bỏ nhiễu không liên quan từ các lần chạy test và tìm kiếm trong khi bảo toàn các lỗi, tóm tắt và các tín hiệu khác mà tác nhân thường cần.
Chính vì vậy JFrog Boost nhắm nén ở cấp độ lệnh, ngay chỗ đầu ra đầu tiên bước vào ngữ cảnh, thay vì cố gắng dọn dẹp cuộc hội thoại sau khi thiệt hại đã nhân lên.
Kết hợp với lớp nén kiểu đó, JFrog Software Supply Chain Platform cung cấp cho các đội một hệ thống ghi chép duy nhất cho các artifact, package và binary mà tác nhân của họ chạm tới.
Để thử JFrog Boost, cài đặt miễn phí tại boost.jfrog.com. Để xem cách JFrog Platform quản trị các artifact và package mà tác nhân của bạn sử dụng, hãy lên lịch demo, tham quan trực tuyến, hoặc bắt đầu dùng thử miễn phí.
Bài viết này được cung cấp chỉ cho mục đích thông tin chung. Nó không phải là tư vấn pháp lý, tuân thủ, hoặc bảo mật và không đảm bảo bất kỳ kết quả bảo mật nào. Kết quả phụ thuộc vào môi trường và cấu hình của bạn. Khả năng sản phẩm khác nhau theo edition và mô hình triển khai và được điều chỉnh theo thỏa thuận của bạn với JFrog. JFrog không soạn thảo hoặc bảo đảm các tài sản AI bên thứ ba được liệt kê trong hoặc quản trị thông qua sản phẩm của họ.
JFrog là nhãn hiệu đã đăng ký của JFrog Ltd. tại Hoa Kỳ. Cursor, Claude, Claude Code, GitHub Copilot, GPT-5, và Python là nhãn hiệu của các chủ sở hữu tương ứng. Tất cả nhãn hiệu khác được tham chiếu trong tài liệu này là tài sản của chủ sở hữu tương ứng. Việc sử dụng những tên này không ngụ ý bất kỳ mối quan hệ hợp tác hay bảo trợ nào.
Các ví dụ mã nguồn được đơn giản hóa minh họa và được cung cấp nguyên trạng cho mục đích giáo dục. Hãy kiểm thử và điều chỉnh trước khi sử dụng trong production.
Nếu bạn muốn giảm chi phí token, cải thiện độ an toàn cho tác nhân và triển khai giải pháp tối ưu hóa đầu ra cho workflow agentic, hãy liên hệ với Softribution để được tư vấn hoặc mua giải pháp.